 Édition Québec · Bêta v2.47.0 (b5)
Vitrine Démocratique
Méthodologie
Comment nous mesurons la saillance médiatique et parlementaire dans l'espace public québécois.
§ 01
Cadre conceptuel
La saillance est définie comme la prépondérance relative d'un enjeu, d'un acteur ou d'une institution dans une sphère d'activité publique donnée, à un moment précis. Ce concept s'inscrit dans la tradition de la théorie de l'agenda-setting (McCombs & Shaw, 1972; Iyengar & Kinder, 1987), selon laquelle les médias et les élus se co-influencent mutuellement dans la construction de l'agenda public.
La Vitrine Démocratique mesure deux dimensions complémentaires de la saillance :
- Saillance médiatique : la présence d'un enjeu ou d'un acteur sur les pages frontales des principaux médias québécois et canadiens, pondérée par la durée passée en Une et par le rythme de renouvellement propre à chaque média (§ 03). La position verticale et le gabarit visuel des manchettes sont enregistrés à la capture (§ 02) mais n'entrent pas, à ce jour, dans le calcul de l'indice.
- Saillance parlementaire : la part du discours législatif (débats à l'Assemblée nationale du Québec) consacrée à un enjeu ou à un parti politique.
Ces deux mesures sont indépendantes et ne sont pas agrégées en un indice composite. Leur rapprochement sur une même interface vise à offrir une vue croisée de l'espace public québécois, sans présumer d'une hiérarchie entre ces sphères.
§ 02
Architecture de collecte : Médias
Capture continue des pages frontales
Le système Radar+, développé et opéré par l'équipe Ellipse Sciences du Centre d'analyse des politiques publiques (CAPP), effectue une capture automatique des pages d'accueil de 13 sources d'information toutes les dix minutes environ, de manière ininterrompue depuis septembre 2018. Pour chaque capture sont enregistrés : la structure HTML de la page, la position verticale et le gabarit visuel de chaque manchette, ainsi que le moment précis de l'extraction (horodatage UTC).
| Code | Source | Langue | Temps moyen en Une (min) |
|---|---|---|---|
| JDM | Journal de Montréal | Français | 143 |
| LAP | La Presse | Français | 121 |
| LED | Le Devoir | Français | 242 |
| RCI | Radio-Canada Info | Français | 160 |
| TVA | TVA Nouvelles | Français | 125 |
| MG | Montreal Gazette | Anglais | 241 |
| CBC | CBC News | Anglais | 159 |
| CTV | CTV News | Anglais | 228 |
| GAM | Globe & Mail | Anglais | 326 |
| GN | Global News | Anglais | 375 |
| NP | National Post | Anglais | 249 |
| TTS | Toronto Star | Anglais | 221 |
| VS | Vancouver Sun | Anglais | 505 |
Le temps moyen en Une est calculé sur trois mois glissants et sert à pondérer l'indice de saillance inter-médias (§ 03).
TVA Nouvelles et le Journal de Montréal appartiennent au même groupe de presse (Québecor) et publient parfois la même manchette à l'identique. Pour ne pas compter deux fois une même décision éditoriale, une manchette syndiquée, c'est-à-dire le même titre publié par les deux sources dans le même bloc de quatre heures (l'unité temporelle de l'analyse, § 03), n'est comptée qu'une seule fois dans les mesures de saillance; les manchettes propres à chaque source comptent normalement.
Collecte des articles
En parallèle des captures de pages frontales, le système extrait le contenu textuel (titre, corps, auteur·e, source) des articles publiés par ces mêmes médias. Ces articles alimentent les modules de couverture par enjeux et par partis politiques.
Extraction des entités nommées
Les objets présents dans les manchettes (personnes, enjeux, institutions, lieux) sont identifiés par un grand modèle de langage, GPT-4o, appliqué au texte des manchettes. C'est cette extraction qui alimente l'indice de saillance publié sur ce site.
Une seconde chaîne est en développement pour la remplacer, fondée sur des modèles ouverts que nous hébergeons nous-mêmes : GLiNER pour la reconnaissance d'entités nommées, et Gemma 3 pour normaliser les entités en français et en anglais (ex. : « Trudeau » et « Justin Trudeau » renvoient au même objet). Elle est évaluée, mais elle n'est pas en service : aucune donnée publiée ici n'en provient. (État vérifié le 27 août 2026.)
La performance des modèles est évaluée régulièrement par comparaison à environ 1 500 phrases annotées manuellement.
§ 03
L'indice de saillance
La saillance est mesurée en blocs de quatre heures ancrés sur l'heure de Montréal (03–07h, 07–11h, 11–15h, 15–19h, 19–23h, 23–03h), qui constituent l'unité temporelle de base de l'analyse. L'ancrage sur l'heure locale plutôt que sur UTC garantit qu'un bloc reste la même tranche de journée toute l'année, y compris aux changements d'heure.
Trois façons d'occuper l'espace médiatique
Une nouvelle peut s'imposer de trois manières différentes, et l'indice les mesure séparément avant de les combiner. Chacune est ramenée sur une échelle de 0 à 1.
| Facette | Question | Mesure |
|---|---|---|
| Visibilité | Combien de médias en ont fait leur Une? | Part des médias suivis de la région qui ont mis l'histoire en Une, en plus du premier. |
| Intensité | Chaque média y consacre-t-il un article ou plusieurs? | Nombre moyen d'articles par média couvrant l'histoire. Un même média ne compte que jusqu'à trois articles : au-delà, un site qui décline abondamment un sujet gonflerait la mesure sans que l'histoire occupe plus de place ailleurs. |
| Durée | Combien de temps est-elle restée en Une? | Temps passé en Une, rapporté au rythme habituel de chaque média : une heure sur une page frontale renouvelée en continu ne vaut pas une heure sur une page qui change deux fois par jour. |
Comment les trois se combinent
Les trois facettes sont réunies par une moyenne géométrique, et non par une addition. La différence est de fond : une addition serait compensatoire, c'est-à-dire qu'une facette très forte pourrait masquer une facette absente. Un seul média qui laisserait un sujet toute la journée en Une obtiendrait alors un score élevé, alors qu'aucun autre média ne l'a jugé digne de sa page frontale. La moyenne géométrique refuse cette compensation : une histoire doit exister sur les trois plans à la fois pour monter, et le plus faible des trois tire l'ensemble vers le bas. Un plancher empêche toutefois qu'une facette nulle annule tout le reste.
L'indice est calculé séparément pour chaque région (les médias québécois d'un côté, les médias canadiens de l'autre), parce qu'une histoire ne se compare qu'aux Unes du même ensemble de médias. C'est ce qui permet au module « Deux solitudes? » de situer chaque camp chez lui plutôt que dans un panier commun.
Le résultat vaut entre 0 et 1; il est affiché sur 100, avec une décimale. Les deux mesures de volume, l'intensité et la durée, saturent : le troisième article d'un même média et la dixième heure en Une comptent moins que le premier article et la première heure, parce qu'au-delà d'un certain point, en faire plus n'occupe pas plus d'espace dans l'actualité. Cent correspond à un plafond théorique : tous les médias, plusieurs articles chacun, sans interruption.
Lire les points
Une manchette n'est pas un instantané : la nouvelle la plus forte du moment est absente de la tranche de quatre heures en cours près de quatre fois sur dix, parce qu'elle a fait sa journée plus tôt. Ce que le site affiche, ce sont donc les points d'attention sur 24 heures : la moyenne des six dernières tranches, les plus récentes comptant davantage (le poids d'une tranche diminue de moitié toutes les dix heures). Les points sont sur la même échelle que l'indice d'une tranche, de 0 à 100 : 100 points correspondraient à une nouvelle en Une de tous les médias, à plusieurs articles, sans interruption pendant 24 heures. Une nouvelle qui n'est plus en Une garde des points pendant quelques heures, puis les perd progressivement.
Un exemple réel, celui d'un sursis accordé par Washington sur des droits de douane, dans la tranche de 23h à 3h du 18 au 19 août 2026 : quatre médias québécois sur six l'avaient en Une, avec sept articles en tout, pendant l'équivalent de cinq Unes de durée normale. Visibilité 0,60, intensité 0,58, durée 0,93 : l'indice de la tranche vaut 68,8. En moyennant les six dernières tranches (20,7, 42,1, 63,8, 62,9, 73,6 et 68,8, de la plus ancienne à la plus récente) avec leur poids de récence, la nouvelle affiche 62,0 points d'attention sur 24 heures, ce qui la place dans le niveau « Exceptionnelle ».
Niveaux de saillance affichés
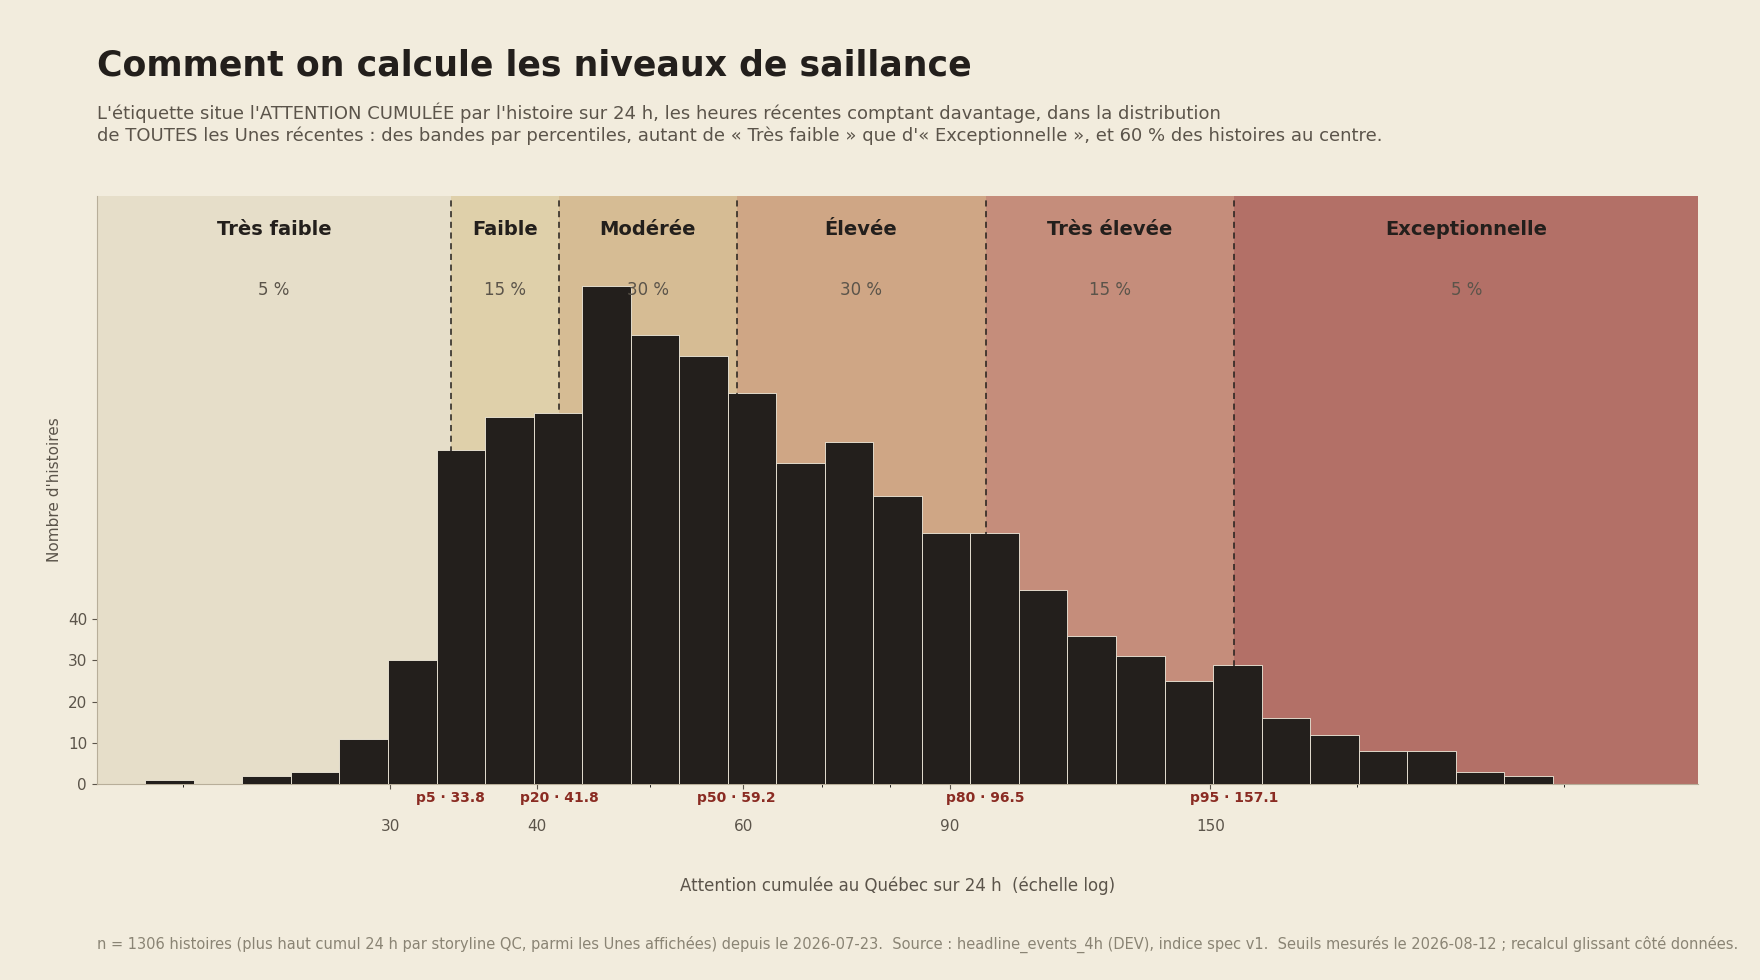
Toutes les nouvelles présentées dans le module « La Une des Unes » ont fait la Une d'au moins un média : elles sont déjà saillantes. L'étiquette de saillance ne dit donc pas si une nouvelle est importante, mais où elle se situe parmi les autres Unes. Ce qui est classé, ce sont les points d'attention sur 24 heures décrits ci-dessus. C'est la même grandeur qui détermine l'ordre des manchettes, de sorte que le niveau affiché et le rang racontent la même chose. Ces points sont comparés à la distribution des mêmes points sur toutes les Unes d'une année, puis classés en six niveaux par percentiles symétriques.
| Niveau | Position (percentile des points d'attention 24h) | Part des Unes | À partir de (points, Unes québécoises) |
|---|---|---|---|
| Très faible | sous le 5e percentile | 5 % | moins de 10,1 |
| Faible | du 5e au 20e percentile | 15 % | 10,1 |
| Modérée | du 20e au 50e percentile | 30 % | 12,5 |
| Élevée | du 50e au 80e percentile | 30 % | 17,7 |
| Très élevée | du 80e au 95e percentile | 15 % | 28,8 |
| Exceptionnelle | au-dessus du 95e percentile | 5 % | 46,9 |
Les bandes sont symétriques : autant de « Très faible » que d'« Exceptionnelle », l'essentiel au centre. La médiane tombe entre « Modérée » et « Élevée », de sorte qu'aucune bande ne représente « la moyenne ». Les seuils sont fixes : ils sont mesurés une fois, sur une année complète de Unes, et ne bougent pas d'une mise à jour à l'autre. Ils ne suivent donc pas l'actualité récente, et c'est délibéré : une même valeur doit porter la même étiquette aujourd'hui et le mois prochain.
Cette référence est provisoire, et il faut le savoir pour lire les niveaux. L'année sur laquelle elle est mesurée n'est pas une année civile, et le panel de médias suivis y a changé en cours de route : elle décrit donc bien la distribution des Unes, mais pas encore une période qu'on puisse nommer proprement. L'indice lui-même, lui, ne bouge pas : il est absolu par construction, et deux valeurs égales mesurent la même chose quelle que soit l'année. C'est la lentille qui est encore à régler, pas l'instrument. Une référence datée et versionnée, mesurée sur une année civile complète, est à l'étude pour la remplacer. Le jour où elle sera posée, le changement sera annoncé : ou bien les niveaux déjà publiés resteront rattachés à la référence sous laquelle ils ont été calculés, ou bien tout sera recalculé sous la nouvelle et ce sera dit. Jamais un mélange des deux, et jamais en silence.
Une propriété mérite d'être signalée, parce qu'elle ne vient d'aucune règle ajoutée : une histoire portée par un seul média reste très bas sur l'échelle. La facette Visibilité y est presque nulle, et comme les trois facettes se multiplient au lieu de s'additionner, aucune des deux autres ne peut compenser : ni le nombre d'articles, ni le temps passé en Une. C'est la traduction d'un principe simple : la saillance décrit une attention collective, et un média seul, aussi insistant soit-il, ne fait pas un agenda. Ce plafond est un constat de mesure et non une impossibilité : un média qui garderait seul une histoire en Une pendant près d'une journée entière peut le franchir. Sur quatorze mois, le cas s'est présenté une fois : un dossier de fond qu'un quotidien a tenu seul en Une une vingtaine d'heures, un samedi d'été, à l'occasion d'une commémoration. Cette histoire a tout juste atteint le bas du niveau « Élevée », loin des valeurs qu'atteignent les nouvelles suivies par l'ensemble des médias : vingt heures de Une continue, chez un seul journal, ne pèsent guère plus qu'une histoire ordinaire suivie par tous. La vérification est refaite à chaque recalibration.
§ 04
Module : L'actualité saillante du moment au Québec & Deux solitudes?
Ce module identifie les événements qui dominent l'agenda médiatique québécois au moment de la consultation, en distinguant l'importance relative accordée par les médias francophones québécois et les médias canadiens anglophones.
Source des données
Le système regroupe les articles qui traitent d'un même fait d'actualité, à partir des captures des pages d'accueil des médias et des articles qui y figurent. Chaque regroupement, appelé « événement », reçoit un enjeu principal et un score de saillance (son importance médiatique), mesuré à la fois à l'échelle de l'ensemble des médias suivis et spécifiquement pour les médias québécois.
Ce regroupement est fait par un modèle de langue, Claude Sonnet 5 (Anthropic) depuis le 30 août 2026, retenu après un banc comparatif de quatre modèles sur trois jours de Unes (23 août 2026) et appliqué rétroactivement à toute la série publiée depuis le 17 mai 2025; GPT-4o, qui l'assurait auparavant, ne subsiste que dans l'extraction des objets décrite au § 02. On lui soumet, toutes les quatre heures, les articles passés en Une pendant la période ainsi que la liste des histoires déjà suivies depuis 24 heures. Il répond à deux questions d'un seul tenant : quels articles forment une même histoire, et laquelle poursuit une histoire de la veille. La consigne définit une histoire comme un dossier d'actualité : l'annonce et la réaction politique, la gestion d'un événement et ses conséquences, la version française et la version anglaise d'un même fait vont ensemble. Elle précise aussi ce qui ne suffit pas à faire un même dossier (un personnage commun, un thème commun, une région commune), pour éviter que deux affaires distinctes soient présentées comme une seule.
Cette méthode a remplacé un regroupement fondé sur la similarité statistique du vocabulaire, qui découpait une même actualité en plusieurs morceaux : chacun paraissait alors moins important qu'il ne l'était, et les médias qui la couvraient se retrouvaient répartis entre ces morceaux. Sur onze semaines d'archives rejouées, le nouveau regroupement reconnaît la suite d'une histoire dans 64 % des cas contre 40 % auparavant, et le nombre d'histoires portées par au moins trois médias québécois passe de 159 à 218.
Le système suit aussi chaque histoire au fil de la journée. Sur une fenêtre glissante de 24 heures, il rassemble l'ensemble des médias qui l'ont mise en Une, le dernier article mis en Une par chacun d'eux, et le moment où elle est apparue pour la première fois parmi les Unes saillantes.
Algorithme : La Une des Unes
- Les événements des 24 dernières heures sont regroupés par histoire (une seule version par fait d'actualité, en priorisant la lecture québécoise), puis l'attention qu'ils ont reçue est cumulée sur cette fenêtre glissante avec une pondération de récence : l'attention récente compte davantage que l'ancienne, son poids diminuant de moitié toutes les dix heures. Une histoire qui a dominé la veille mais que plus personne ne met en Une cède ainsi sa place, sans que la fenêtre perde le cycle complet d'une journée. Le module et le panneau « Deux solitudes » partent de la même fenêtre et du même regroupement d'histoires : chaque manchette retenue ici figure aussi parmi les axes du radar, qui peut en outre montrer des histoires saillantes seulement du côté canadien.
- Les événements provenant uniquement de médias américains sont écartés du classement, ainsi que de tous les calculs de saillance et de convergence. Ils restent lus à part, pour une seule question, décrite plus bas : le même sujet est-il aussi en Une aux États-Unis?
- Les histoires les plus saillantes au Québec sur ces 24 heures sont retenues et présentées en mise en page éditoriale (jusqu'à trois manchettes : une principale et des secondaires). Les places sont attribuées au classement, sans condition sur le nombre de médias : une histoire portée par un seul média peut donc figurer parmi les manchettes, et son niveau de saillance dit alors honnêtement où elle se situe : l'indice tient compte du nombre de médias, une couverture isolée ne peut pas atteindre les niveaux élevés. Une manchette secondaire n'apparaît toutefois que si elle a retenu au moins la moitié de l'attention de la plus forte histoire encore à la Une : le nombre de manchettes affichées reflète ainsi la journée elle-même. La comparaison se fait avec une histoire que les médias couvrent encore, et non avec une histoire dont l'attention accumulée tient surtout à son passé; sans cette précision, une nouvelle en cours pouvait être écartée de l'écran parce qu'elle ne faisait pas la moitié d'une histoire que plus aucun média ne portait. Quand une histoire domine largement, elle reste seule; quand deux ou trois se tiennent, elles sont toutes montrées, quel que soit leur niveau. La comparaison se fait entre les histoires du moment, jamais contre un seuil fixe : une journée calme affiche donc bien ses trois manchettes, chacune avec son niveau réel. Cette règle ne concerne que l'affichage : l'indice est calculé et conservé pour toutes les histoires. Le niveau affiché situe la nouvelle parmi les manchettes portées par au moins deux médias québécois : c'est le groupe de comparaison, et il ne dépend pas de ce qui est affiché à l'écran. L'ordre des manchettes suit directement cette attention cumulée : une histoire qui a culminé pendant la nuit reste en Une le lendemain matin, puis glisse d'elle-même vers les manchettes secondaires (et finit par sortir) à mesure que de plus grosses histoires émergent. C'est le même classement que celui du panneau « Deux solitudes », de sorte que les deux vues racontent la même actualité. Quand deux histoires très proches sont identifiées comme une seule et même actualité, un seul, le plus saillant, est retenu; cette identification est automatisée et peut occasionnellement laisser passer un doublon. Le module présente donc de une à trois manchettes, selon ce que l'actualité offre réellement.
- Pour chaque histoire, le niveau de saillance affiché (de « Très faible » à « Exceptionnelle ») provient du classement par percentiles décrit au § 03, appliqué aux points d'attention sur 24 heures décrits au même endroit : c'est la même grandeur qui détermine l'ordre des manchettes, de sorte que le niveau affiché et le rang racontent la même chose. Ce niveau redescend à mesure qu'une histoire s'éteint : il décrit où elle en est, non ce qu'elle a été à son plus fort. Le niveau affiché est une fonction directe de cette valeur : dès qu'une nouvelle franchit un seuil, elle porte le palier correspondant, à la hausse comme à la baisse. Deux nouvelles de même attention cumulée affichent donc toujours le même niveau, condition nécessaire pour qu'un niveau puisse se comparer d'une période à l'autre. Un mécanisme d'amortissement retardait auparavant les changements de palier; il a été retiré, parce qu'il faisait dépendre le niveau affiché de l'historique de la nouvelle et non de sa seule valeur. La taille du titre et de l'image suit ce niveau : plus une nouvelle est saillante, plus elle occupe d'espace. Un bouton d'information situe la nouvelle sur la distribution de toutes les Unes de l'année. Cette comparaison se fait sur le sommet que l'histoire a atteint, et non sur sa valeur du moment : une nouvelle qui a compté parmi les plus marquantes de l'année ne cesse pas de l'avoir été parce que les médias sont passés à autre chose. Le niveau affiché juste à côté, lui, continue de dire où elle en est maintenant; les deux répondent à deux questions différentes.
- À côté du niveau, une petite courbe de tendance retrace la même attention cumulée que le niveau lui-même, édition par édition sur les 24 dernières heures. Hauteur et niveau disent donc toujours la même chose : un point plus haut est un niveau plus élevé, sans exception. Un point creux marque une édition où aucun média québécois n'avait l'histoire en Une : l'attention accumulée reste alors visible et continue de décroître, ce qui explique qu'une nouvelle puisse conserver un niveau élevé alors qu'elle vient de quitter les pages frontales. Le point noir marque le sommet atteint. Une flèche donne le sens du mouvement et une pastille en donne l'ampleur, en pourcentage de variation depuis l'édition précédente; la valeur en points suit. Une histoire qui vient d'apparaître est marquée Nouveau, une histoire qui revient après une absence, Retour. L'attention retombe souvent alors que la manchette reste affichée : le classement portant sur 24 heures, une nouvelle peut rester en Une alors que les médias sont déjà passés à autre chose. Survoler chaque point révèle le moment, le niveau de saillance d'alors, la valeur en points et sa variation.
- La byline « À la Une aujourd'hui sur » liste les médias québécois qui ont mis l'histoire en Une au cours des 24 dernières heures, pas seulement dans le bloc courant; « Absent de la Une sur » désigne ceux qui ne l'ont mise en Une à aucun moment de cette fenêtre. Chaque nom de média pointe vers le dernier article que ce média a mis en Une sur l'histoire.
- Quand la même histoire est aussi en Une ailleurs, une mention le signale juste sous cette byline : « Résonance canadienne » lorsque des médias canadiens anglophones l'ont mise en Une, « Résonance américaine » lorsque ce sont des médias américains. Les deux peuvent apparaître ensemble, et elles ne sont jamais fondues en une seule mention : un sujet québécois repris à Toronto et un sujet repris à New York ne disent pas la même chose. Un bouton d'information donne, pour chacune, la part de l'attention que cette région a consacrée à l'histoire (la même mesure que celle des axes du radar « Deux solitudes »), puis la liste des médias de la région qui l'ont mise en Une, chaque nom pointant vers son article.
- Le regroupement des articles en une même histoire est automatique, et il lui arrive encore d'absorber un article portant sur un autre sujet, ce qui crédite alors un média d'une Une qu'il n'a pas faite. C'est la raison pour laquelle la consigne de regroupement (§ plus haut) énonce explicitement ce qui ne fait pas une même histoire. Une vérification distincte, appliquée article par article après le regroupement, a été essayée puis retirée : mesurée sur onze semaines, elle défaisait plus de regroupements justes qu'elle ne corrigeait d'erreurs, parce qu'elle jugeait chaque article contre le seul titre de la manchette et écartait donc les autres facettes du même dossier. La couverture affichée peut ainsi, dans une minorité de cas, comprendre un média de trop.
Algorithme : Deux solitudes
Ce panneau compare, sur les 24 dernières heures, ce que mettent de l'avant les médias québécois et les médias canadiens (hors Québec). Il mesure dans quelle mesure les deux espaces médiatiques couvrent les mêmes histoires, et non les mêmes articles.
- La mesure de fond est la part d'attention consacrée aux histoires couvertes des deux côtés. Pour chaque région, on rapporte l'attention portée aux histoires que l'autre région suit aussi à son attention totale, puis on fait la moyenne des deux. 0 % = aucune histoire commune; 100 % = les deux régions se concentrent entièrement sur les mêmes histoires. La divergence en est le complément.
- Le grand chiffre affiché est l'écart entre cette part et son niveau habituel (la médiane d'une année complète de référence), avec sa direction : « plus convergent » ou « plus divergent » que d'habitude. L'infobulle ⓘ précise l'intensité : « un peu » quand l'écart reste dans la plage des journées ordinaires, « nettement » quand le moment en sort (plus convergent que 80 % des fenêtres de l'année de référence, ou plus divergent que 80 % d'entre elles). Le niveau absolu du moment reste accessible : il s'affiche au survol du marqueur de la jauge et dans l'infobulle ⓘ. Tout le module chiffre une seule et même grandeur, la convergence (la part d'attention consacrée aux mêmes histoires), du grand chiffre à la jauge, en passant par les infobulles et le partage; les mots « divergent » et « convergent » n'en nomment que les deux sens.
- Au bout de chaque sujet, un repère indique son niveau de saillance, situé parmi les Unes des médias de sa région : un sujet porté surtout par les médias canadiens est comparé aux Unes canadiennes, un sujet porté surtout par les médias québécois aux Unes québécoises. Un même sujet peut donc être « exceptionnel » d'un côté et « élevé » de l'autre : ce n'est pas une contradiction, c'est précisément ce que le module donne à voir. Le survol du sujet lui-même donne la part d'attention de chaque région; le survol du repère donne le niveau et ce qu'il signifie. Ce repère situe le sujet tel qu'il est sur les 24 dernières heures, et non à son sommet : le panneau montre un instant de l'actualité, pas la carrière d'une histoire. C'est ce qui le distingue du bouton d'information de la Une des Unes, qui situe une manchette par le sommet qu'elle a atteint. Les deux répondent à deux questions différentes, et chacun nomme désormais ce qu'il compare, à qui et sur quelle période, sans quoi deux pourcentages mesurés contre des règles différentes se liraient comme une contradiction.
- Chaque axe du radar est une histoire saillante des 24 dernières heures, tirée du même regroupement que la Une des Unes : l'union des histoires les plus suivies au Québec et au Canada (jusqu'à six axes), de sorte que les manchettes de la Une figurent toutes sur le radar. Sa distance au centre est la part d'attention que la région lui a consacrée sur cette fenêtre glissante (avec la même pondération de récence que la Une des Unes), exprimée en pourcentage de toute l'attention de la région (les anneaux du radar en indiquent l'échelle). Comme chaque côté est ramené à sa propre attention totale, les deux formes sont directement comparables malgré le nombre de médias différent.
- Sous le radar, une échelle situe le résultat entre divergence totale (à gauche) et convergence totale (à droite). Elle est graduée de 0 % à 100 % de convergence, dans ce sens : le marqueur se lit donc directement comme la part d'attention consacrée aux mêmes histoires. Le repère « habituel » marque le niveau courant, mesuré sur une année complète : environ la moitié de l'attention va aux mêmes histoires. L'autre moitié va, de chaque côté, à des histoires que l'autre région ne met pas en Une : c'est là que vivent les deux solitudes.
Limites et honnêteté
- L'indice mesure les mêmes sujets saillants, pas les mêmes histoires : deux médias peuvent parler de la même personne pour des raisons différentes, ou de la même histoire en la rattachant à des objets différents.
- Environ un dixième des sujets québécois portent du texte français résiduel non apparié côté canadien, ce qui abaisse légèrement la convergence mesurée.
- Les événements sont regroupés à partir des médias québécois, canadiens et américains ensemble; c'est ce qui permet de reconnaître qu'une même histoire est couverte des deux côtés de la frontière. Le radar n'en affiche toutefois que les parts québécoise et canadienne; la part américaine n'apparaît que dans la mention « Résonance américaine » de la Une des Unes.
- Le rapprochement entre une manchette québécoise et une Une américaine est automatique et repose en partie sur la proximité des titres : une reprise formulée très différemment peut lui échapper. L'absence de mention « Résonance américaine » signifie donc « aucune reprise reconnue », et non « aucune reprise ».
- Le repère « habituel » de la jauge se lit contre une référence fixe, comme les niveaux de saillance (§ 03) : sa médiane et ses bornes « un peu » / « nettement » sont mesurées sur une année complète d'historique, avec le regroupement d'histoires actuel appliqué uniformément, puis posées dans le code. Une même part d'attention reçoit donc toujours la même lecture, quel que soit le jour où elle est observée. Cette référence est provisoire au même titre que celle du § 03, et suivra la même règle le jour où une référence datée la remplacera : le changement sera annoncé, jamais fait en silence.
- Les deux échelles de saillance du radar reposent sur la même mesure : de chaque côté, le niveau d'un sujet est établi sur son intensité cumulée des 24 dernières heures, située dans l'historique d'un an des Unes de sa propre région. Un sujet québécois se compare aux Unes québécoises, un sujet canadien aux Unes canadiennes, et les niveaux des deux côtés se comparent directement entre eux. Si l'historique canadien venait à manquer lors d'une mise à jour, le niveau serait provisoirement établi sur l'intensité de pointe de la fenêtre, comme avant.
- Le chevauchement visuel des deux formes du radar ne mesure pas la convergence : il dépend de la position des sujets autour du cadran, qui suit leur ordre de saillance. Deux régions peuvent suivre les mêmes histoires avec des intensités différentes sans que leurs formes se recouvrent beaucoup. Le score, lui, est calculé sur les parts d'attention consacrées aux histoires communes, pas sur le dessin.
Affichage
Un radar à deux formes superposées (le Québec en bleu, le Canada en rouge) montre d'un coup d'œil qui parle de quoi : chaque forme dessine où sa région porte son attention. Le degré de convergence se lit dans le grand chiffre et la jauge, pas dans le recouvrement des formes (voir « Limites et honnêteté »). Autour, chaque sujet porte les logos des médias qui l'ont couvert, cliquables vers leur dernier article. Sur un écran étroit, où les titres ne tiendraient pas autour du radar, les axes sont numérotés et les sujets se lisent dans une liste sous le radar, avec les mêmes logos. Un grand pourcentage indique l'écart avec le niveau habituel de convergence, et le libellé qui l'accompagne en donne le sens et l'intensité (plus divergent ou plus convergent que d'habitude); une bulle d'information en détaille la lecture. Sur l'axe fleur-de-lys/érable, la distance entre les deux symboles encode la convergence : ils se rapprochent quand les deux agendas se recoupent, s'éloignent quand ils divergent. La jauge situe le moment sur l'échelle complète, de la divergence totale à la convergence totale; le survol de son marqueur donne les niveaux absolus du moment et de l'habituel.
§ 05
Module : Les 12 enjeux de la campagne
Anciennement « De quoi parle-t-on? ».
Ce module représente la distribution de la couverture médiatique par grand enjeu de société sur la période sélectionnée (Jour · Semaine · Campagne).
Enjeux couverts
| Grand enjeu de société |
|---|
| Économie et travail |
| Gouvernements |
| Santé |
| Environnement |
| Droits et libertés |
| Culture |
| Éducation |
| Aff. internationales |
| Loi et crime |
| Terres publiques |
| Immigration |
| Technologie |
Ces douze enjeux regroupent les 21 grands thèmes du Comparative Agendas Project, une grille internationale de codage des politiques publiques, selon la classification établie par la CLESSN pour le Polimètre. Quelques regroupements méritent d'être nommés : le transport et le logement comptent dans « Économie et travail », avec la macroéconomie, le travail, le commerce intérieur et le commerce extérieur; la santé et l'aide sociale forment « Santé »; l'environnement et l'énergie, « Environnement »; les affaires internationales et la défense, « Aff. internationales »; les terres publiques et l'agriculture, « Terres publiques ». « Culture » ne contient que la culture et le nationalisme.
Source des données
Le système produit, pour chaque fenêtre temporelle et chaque bloc de collecte (matin, midi, après-midi), un score de couverture pour chacun des 12 grands enjeux.
Algorithme
- Le système analyse le contenu textuel des articles de chaque bloc de quatre heures et calcule un score de saillance pour chacun des 12 enjeux.
- Pour la période choisie, les scores du traitement le plus récent sont additionnés pour chaque enjeu.
- Les scores cumulés déterminent la surface de chaque tuile (plus un enjeu est saillant, plus sa tuile est grande) ainsi que le classement des enjeux, du plus au moins saillant.
- La part de l'attention de chaque enjeu est son score cumulé divisé par la somme des scores des douze, en pourcentage. Les douze parts totalisent donc 100 % (à l'arrondi près, chaque part étant affichée à une décimale) : c'est une répartition de l'attention entre les enjeux, pas une mesure absolue de couverture.
- Pour la vue du jour, on calcule aussi la variation de saillance de chaque enjeu par rapport au traitement précédent, exprimée en pourcentage (hausse ou baisse). Le module est republié six fois par jour : l'heure du traitement auquel la variation se compare est affichée avec elle, et l'heure de la dernière mise à jour figure au bas du module. Ce sont les heures des éditions (0h, 4h, 8h, 12h, 16h, 20h), en heure de Montréal : un bloc de données est servi une heure après sa fin, comme partout ailleurs sur le site.
- Pour les vues hebdomadaire et mensuelle, le classement des enjeux est conservé à chaque traitement, ce qui permet d'en retracer l'évolution dans le temps.
- Pour chaque enjeu, la liste montre les six articles qui l'abordent le plus sur la fenêtre choisie, avec leur média et leur part de l'enjeu. Ces articles sont ceux-là mêmes qui composent le pourcentage : le nombre affiché et la liste qui l'accompagne sortent de la même mesure, article par article et phrase par phrase. La tuile annonce aussi combien d'articles portent l'enjeu au total, avant la coupe à six.
- Un article peut figurer sous plusieurs enjeux, avec des poids différents, et sans que l'enjeu soit son sujet principal : un texte qui n'aborde le climat qu'en passant compte tout de même pour l'environnement, à hauteur de ce qu'il en dit. C'est le sens de la mesure : elle pèse ce dont les médias parlent, pas ce qu'annoncent les titres.
- Auparavant, cette liste montrait des événements, c'est-à-dire des histoires regroupées et nommées, tirées d'une autre table que le pourcentage. Les deux ne couvraient pas la même population : un enjeu pouvait peser 13,9 % de l'attention sans qu'aucun événement ne lui soit rattaché, alors que plus de mille articles l'abordaient. Le nombre et la liste viennent désormais de la même source.
- Chaque actualité porte son sommet de saillance : le bloc de quatre heures où elle a le plus compté, calculé sur toutes ses occurrences et non sur un relevé isolé. S'y ajoutent le niveau de saillance atteint à ce sommet et sa valeur. Le niveau est nommé sur la même échelle que celle de l'actualité saillante du moment, pour qu'un « élevée » veuille dire la même chose d'un module à l'autre. ⚠️ La valeur, elle, est celle du bloc de pointe et non le cumul sur 24 h du grand nombre de l'actualité saillante : deux échelles distinctes, qui ne s'additionnent pas. Les actualités sont classées de la plus récemment culminante à la plus ancienne, et la liste se lit en colonnes : le haut du classement occupe la colonne de gauche, la suite passe à droite. Une liste courte tient dans une seule colonne.
- Un enjeu peut n'avoir aucune actualité sur la fenêtre choisie. Il le dit alors en toutes lettres, plutôt que d'afficher autre chose. Ce n'est pas une contradiction avec sa part de l'attention : la part est calculée sur l'ensemble de la couverture des médias québécois, tandis que la liste ne retient que les actualités devenues saillantes au point d'être constituées en événement. Un enjeu peut donc peser lourd sans qu'aucune histoire précise ne s'en détache.
Le symbole de chaque enjeu
Chacun des douze enjeux porte un symbole qui lui est propre, en plus de sa couleur. Un enjeu donné garde son symbole et sa couleur partout où il apparaît : sur la rubrique de l'actualité saillante, sur les rubriques du radar des Deux solitudes, sur les tuiles de ce module, à côté des promesses du Polimètre+ et sur les sujets abordés à l'Assemblée. Un même enjeu se reconnaît donc d'un module à l'autre sans avoir à relire son nom.
Le symbole n'est pas un ornement : il reste lisible là où le nom ne l'est plus. Sur les plus petites tuiles, le nom de l'enjeu était rogné jusqu'à ne plus désigner personne; c'est désormais le symbole seul qui l'identifie, le nom complet restant accessible au survol et dans la tuile dépliée. Sur les tuiles les plus plates, où le symbole et le pourcentage ne tiennent pas ensemble, c'est le pourcentage qui est conservé.
Affichage
Deux réglages indépendants : la fenêtre temporelle (Jour, Semaine, Campagne) et la représentation (Répartition ou Évolution). Les six combinaisons existent. La vue affichée par défaut est Campagne, en Répartition : c'est la fenêtre où le plus grand nombre d'enjeux portent des actualités, et sa variation se compare à la veille plutôt qu'au traitement précédent. Auparavant, la répartition n'était offerte que pour le jour et l'évolution que pour la semaine et la campagne, ce qui interdisait de comparer une même fenêtre des deux façons.
- Répartition : une grille de tuiles colorées (une couleur et un symbole par enjeu) dont la surface suit la saillance. Chaque enjeu dispose d'une aire minimale garantie : le module s'appelle « Les 12 enjeux » et doit les montrer tous les douze, y compris ceux dont la saillance est nulle, qui se réduiraient autrement à un filet illisible. La surface n'est donc pas strictement proportionnelle : elle reste ordonnée (un enjeu plus saillant occupe toujours une plus grande tuile), mais elle resserre l'écart entre les extrêmes. Le nombre inscrit sur chaque tuile, lui, reste la part exacte. Chaque tuile affiche le nom de l'enjeu, sa part de l'attention médiatique (le nombre principal, qui chiffre ce que la surface montre) et la variation de sa saillance (une hausse ou une baisse, en pourcentage). En vue Jour, cette variation compare le traitement courant au précédent. En vues Semaine et Campagne, elle compare la part de l'enjeu à celle qu'il avait la veille dans la même fenêtre (les sept jours arrêtés à la veille, ou la campagne jusqu'à la veille) : elle dit si l'enjeu gagne ou perd du terrain, et non si le volume total grossit. Sur les tuiles trop petites pour porter les deux nombres, la variation se réduit à sa flèche : le chiffre exact se lit au survol et dans la tuile dépliée. Sur téléphone, la grille devient une liste de barres proportionnelles portant la même part. Sur ordinateur, le survol révèle l'actualité principale de l'enjeu et les médias qui la couvrent. Un clic agrandit ensuite la tuile à toute la visualisation et affiche toutes les actualités récentes associées, avec les médias propres à chacune. Cette variation indique si un enjeu gagne ou perd en importance d'une mise à jour à l'autre; elle ne compare pas une journée à la précédente.
- Évolution : un graphique retrace l'évolution du classement des douze enjeux. Pour la semaine et la campagne, un point par jour; pour le jour, un point par publication, l'axe portant alors les heures des éditions plutôt que des dates. La semaine couvre les sept derniers jours (le jour de l'édition et les six qui le précèdent, en heure de Montréal), et la campagne part du déclenchement du scrutin, le 27 août 2026. Sur ordinateur, toutes les trajectoires sont présentées ensemble. Sur mobile, une trajectoire est mise en évidence à la fois; une liste classée permet de choisir l'enjeu suivi, tandis que les onze autres restent visibles en arrière-plan. En sélectionnant un enjeu, on affiche ses actualités récentes, avec un lien vers l'article sur le site du média.
§ 06
Module : De quel parti parle-t-on dans les médias?
Anciennement « Couverture médiatique des partis politiques ».
État actuel : la mesure a repris. Le modèle qui reconnaît les partis a été réentraîné : à la place d'un classifieur unique, neuf modèles binaires jugent chacun d'un seul parti. Sur notre jeu de validation annoté par quatre personnes, la justesse passe de 0,61 à 0,94.
Deux réserves demeurent, et nous les affichons plutôt que de les taire. Le Parti conservateur du Québec n'est plus reconnu du tout : il ne comptait que 18 exemples d'entraînement, dont la majorité désignaient en réalité des conservateurs d'une autre province. Sa colonne restera donc à zéro, et ce zéro dit notre incapacité à le mesurer, pas son absence des médias. Par ailleurs, quatre partis reposent sur peu d'exemples positifs : leurs chiffres sont à lire comme des ordres de grandeur. Voir le point 10 du § 10.
Ce module mesure la part de voix des partis politiques québécois (la portion du temps de une qui revient à chacun, lorsque les médias parlent d'un parti) ainsi que le ton de ce traitement, dans la couverture des six médias québécois suivis : TVA Nouvelles, La Presse, Le Journal de Montréal, Le Devoir, Radio-Canada et le Montreal Gazette. Les partis fédéraux, eux, restent mesurés sur les 13 sources : deux paniers différents pour deux questions différentes. La part de voix ne dit donc pas quelle place les partis occupent dans l'actualité en général, où elle est bien plus modeste : elle répartit entre eux l'attention qui leur est consacrée.
Partis provinciaux suivis
| Parti provincial suivi |
|---|
| Coalition avenir Québec (CAQ) |
| Parti québécois (PQ) |
| Parti libéral du Québec (PLQ) |
| Québec solidaire (QS) |
| Parti conservateur du Québec (PCQ) |
Source des données
Le système produit, pour chaque parti et chaque date, deux mesures : une part de voix et un ton, sur trois fenêtres (la journée, la semaine et l'ensemble de la période conservée). Les compteurs sont mis à jour six fois par jour, au fil des collectes.
Algorithme
- Les articles sont découpés en phrases. Chaque phrase passe par deux classifieurs entraînés : l'un estime quels partis y sont évoqués, l'autre la tonalité du passage.
- Une phrase n'est retenue pour un parti que si la confiance du classifieur dépasse un seuil propre à ce parti. Ces seuils sont fixés parti par parti, de façon à écarter les mentions incertaines. Un même degré de confiance n'a pas la même valeur d'un parti à l'autre.
- Part de voix : pour chaque parti, on additionne le temps passé en une par les articles qui l'évoquent, puis on rapporte ce total à celui de l'ensemble des partis québécois. Les cinq parts se partagent donc 100 %.
- Ton : moyenne des tonalités des articles retenus, pondérée par leur temps en une. Un article longtemps exposé pèse davantage qu'un article vite remplacé.
- Les compteurs repartent de zéro à date fixe : chaque jour à minuit, chaque lundi et le premier de chaque mois, à l'heure de Montréal. Il ne s'agit donc pas de moyennes glissantes, mais d'accumulations depuis le début de la période en cours.
Affichage
Chaque parti occupe une colonne dont la hauteur donne sa part de voix. Trois onglets (Jour, Semaine et Campagne) font varier la fenêtre observée. Un repère signale le niveau habituel de chaque parti, ce qui permet de voir s'il est au-dessus ou en dessous de son ordinaire, et une courbe retrace l'évolution récente.
Le parti dont les médias parlent le moins sur la période est mis en « sourdine » : sa colonne affiche quand même sa part, en gris, car un parti peu présent est une information en soi. Ce n'est pas un seuil sur la part de voix, mais un rang : le dernier du classement y passe toujours, quelle que soit sa part; en cas d'égalité au plus bas, les partis à égalité y passent tous. Un parti n'est retiré des données elles-mêmes qu'en deçà de 2 %, seuil distinct de la sourdine d'affichage.
Lorsque la répartition par média est disponible, un curseur permet de passer de l'ensemble des médias à un média en particulier. Les couleurs indiquent alors si ce média accorde à un parti plus ou moins de place que la moyenne des autres.
§ 07
Module : Polimètre+ : promesses électorales à la Une
Ce module suit la couverture médiatique des promesses électorales de la Coalition avenir Québec (CAQ) : il identifie chaque jour, sur une semaine glissante, les promesses les plus saillantes (les plus présentes dans l'actualité) et celles en plus forte progression par rapport à la semaine précédente.
Source des données
Le module croise la couverture médiatique avec la liste officielle des promesses de la CAQ. L'appariement entre un article et une promesse est fait par un modèle : un classifieur détermine si un paragraphe contient une promesse, puis un modèle de langage (Gemma 3) détermine laquelle, parmi la liste officielle. Les expressions régulières validées manuellement demeurent dans le pipeline comme méthode de repli et comme étalon de comparaison.
Réserve explicite. La concordance entre l'identification par modèle et l'identification par règles a été mesurée sur un échantillon indépendant (micro-F1 de 0,324). Ce chiffre mesure un accord avec les règles, pas une exactitude : une promesse réellement mentionnée qu'aucune règle ne couvre y compte comme une erreur du modèle. L'arbitrage humain des désaccords est en cours. La bascule a été faite pour observer le comportement du modèle en conditions réelles; le module est servi par un environnement de développement.
Algorithme
- Identification (modèle) : le corps de chaque article est découpé en paragraphes. Un classifieur écarte d'abord les paragraphes sans promesse, puis un modèle de langage détermine, pour chacun des paragraphes retenus, laquelle des promesses de la liste officielle y est mentionnée (ou aucune). Cette étape tourne en continu, par blocs de 4 heures, et non au moment du calcul : le classement hebdomadaire lit son résultat. À défaut (service indisponible, semaine pas entièrement examinée), la semaine est identifiée par les règles, soit un jeu d'expressions régulières validées, une par promesse.
- Indice de saillance : pour chaque promesse, nombre d'articles la mentionnant multiplié par le temps de présence en Une pondéré entre médias (même pondération inter-médias que l'indice de saillance décrit au § 03).
- Progression hebdomadaire : écart entre l'indice de saillance de la semaine courante et celui de la semaine précédente, permettant de repérer les promesses dont la couverture s'intensifie.
- Les promesses sont classées par saillance et par progression pour la semaine se terminant à la date du traitement.
Enrichissement génératif (optionnel)
En complément de l'identification décrite ci-dessus, et sans intervenir dans le calcul de l'indice, un modèle de langage génératif (Gemma 3) produit deux éléments d'affichage : un libellé court pour chaque promesse et un résumé journalistique (2 à 3 phrases) décrivant comment la promesse a été couverte pendant la période, à partir des titres des articles qui l'ont mentionnée (résumé hebdomadaire, puis synthèse mensuelle des résumés hebdomadaires). Un résumé déjà rédigé est repris tel quel tant que la couverture qu'il décrit n'a pas changé, et la synthèse mensuelle est renouvelée une fois par semaine; elle n'est rédigée que si le résumé de la semaine en cours existe. Cet enrichissement est optionnel : si le service n'est pas disponible, le résumé affiché est le dernier rédigé il y a moins de sept jours pour cette promesse; à défaut, la synthèse mensuelle reprend le résumé de la semaine, et sinon le champ reste vide. Le reste du module est publié normalement.
Affichage
Classement des promesses de la CAQ les plus saillantes de la semaine, avec l'indication de leur progression et, lorsque disponible, un libellé court et un résumé de la couverture médiatique récente.
Le repli sur les règles vaut pour une semaine entière, jamais pour une partie de semaine. La vue d'un mois cumulant quatre semaines, elle peut donc réunir des semaines identifiées par le modèle et des semaines identifiées par les règles : les deux méthodes ne repèrent pas les mêmes promesses, et les volumes ne se comparent pas d'une semaine à l'autre lorsque la méthode change.
Volet « promesses de la campagne »
Pendant la campagne électorale de 2026, le module se dote d'un second volet, affiché au-dessus des promesses de 2022 et mis en service au fil de la campagne : les promesses formulées par les partis dans leurs communiqués et leurs plateformes, classées selon l'écho qu'elles reçoivent dans les Unes. Ce volet n'apparaît qu'à partir du moment où au moins une promesse a été reprise en Une; avant, le module ne montre que les promesses de 2022. Il ne porte pas sur la liste officielle des promesses du mandat précédent, mais sur ce que les partis annoncent au fil de la campagne. Une promesse qui vient d'être formulée n'a pas d'état de réalisation : la pastille indique le parti, pas un verdict.
Source des données. Les communiqués publiés par les cinq partis reconnus sur leurs sites officiels et les sections de leurs plateformes électorales, depuis le 1er août 2026. Chaque document est examiné une seule fois. Un modèle de langage (Gemma 3) détermine d'abord s'il contient une promesse électorale (un engagement de faire quelque chose s'il est élu, et non une annonce de candidature ni une annonce gouvernementale), puis en extrait le texte, cité tel quel. Le titre affiché est un libellé court écrit par le modèle; le texte de la promesse, cité en dessous, est un verbatim du document. La consigne de repérage écarte les engagements pris par un candidat en son nom propre pour sa seule circonscription : seul ce que le parti promet compte.
- Appariement à la couverture : les Unes des cinq médias québécois francophones sont découpées en paragraphes. Un paragraphe n'est rattaché à une promesse que s'il nomme lui-même le parti qui l'a formulée ou son chef (le titre de l'article ne suffit pas); les partis sont repérés avec le même dictionnaire que les autres modules. Le modèle de langage vérifie ensuite que le paragraphe rapporte bien une promesse électorale au sens du Polimètre (un engagement vérifiable), et non un sondage, une candidature ou une controverse. Il détermine alors laquelle des promesses de ce parti le paragraphe reprend, parmi les trente qui partagent le plus de vocabulaire avec lui, même si les médias la formulent autrement; une reprise qui n'a aucun mot en commun avec la promesse peut donc lui échapper. Chaque rattachement est ensuite confirmé par une seconde question, promesse par promesse.
- Cumul par bloc de 4 heures : cet appariement se fait bloc par bloc, en continu, et chaque verdict est conservé. Un paragraphe encore en Une au bloc suivant n'est pas réexaminé; il l'est seulement sur les promesses détectées après son premier examen, pour qu'une promesse annoncée le matin ne soit pas ignorée par la couverture de la même matinée.
- Formulations en double : une même promesse peut être formulée plusieurs fois, dans deux communiqués ou deux sections d'une plateforme. Avant le calcul de l'indice, ces formulations sont réunies sous la plus anciennement annoncée, et un paragraphe rattaché à plusieurs d'entre elles ne compte qu'une fois. Deux formulations ne sont réunies que si elles viennent du même parti, que leurs libellés courts ne portent pas chacun un chiffre absent de l'autre, et qu'elles sont très proches selon un modèle de représentation du sens des phrases (un peu moins proches suffit quand elles portent le même libellé court); dans le doute, elles restent séparées. Une promesse reformulée très librement peut donc encore apparaître deux fois, et si le service qui compare les formulations est indisponible, aucune n'est réunie lors de cette mise à jour.
- Indice de saillance : pour chaque promesse, nombre de paragraphes de Une qui la reprennent multiplié par leur temps de présence en Une, normalisé. C'est la même grandeur que pour les promesses de 2022, pour que le rang veuille dire la même chose d'un volet à l'autre. La même dépêche reprise par deux médias compte deux fois, avec le temps de chacun.
- Fenêtres : « Aujourd'hui » somme les six derniers blocs complets (24 heures glissantes), « Depuis une semaine » les quarante-deux derniers, et « Campagne » tous les blocs depuis le déclenchement des élections, le 27 août 2026 (la même période que l'onglet Campagne des autres modules). Une promesse entre dans une fenêtre si au moins un média l'a reprise pendant cette période, quelle que soit sa date d'annonce; sans écho, elle n'y figure pas, et l'onglet peut être vide. Les fenêtres de la semaine et de la campagne ne sont pas recalculées à chaque mise à jour du module; tant qu'une fenêtre n'a pas été publiée, l'onglet le dit plutôt que d'afficher un classement vide.
Réserve explicite. L'extraction des promesses fonctionne; l'appariement d'une promesse à sa couverture est le maillon le moins sûr. Mesuré hors campagne, où presque aucun communiqué ne contient de promesse, il produisait surtout des faux positifs. Ce volet est publié pendant la campagne précisément pour être mesuré sur des données réelles, et sa méthode peut changer en cours de route.
§ 08
Module : L'alignement de l'Assemblée
Ce module mesure la présence des partis politiques dans les débats de l'Assemblée nationale du Québec (ANQ) selon trois fenêtres : la dernière journée de débats publiée, la session en cours et la législature complète.
Source des données
Le système traite les transcriptions officielles des débats de l'ANQ. Chaque intervention est découpée en phrases, puis chaque phrase reçoit un ou plusieurs enjeux (même taxonomie qu'au § 05) et une valeur de ton. De là viennent, pour chaque parti et chaque période : le nombre d'interventions, le volume de mots prononcés, la diversité lexicale (part de mots différents dans le vocabulaire), le ton moyen, la répartition par enjeu. Les mêmes mesures sont calculées par député, avec en plus un concept distinctif, l'expression qui distingue l'élu des autres.
Les segments vides ou sans aucune lettre, produits par le découpage automatique, sont écartés avant toute analyse. Les passages de pure procédure (« je cède la parole à… », les préambules de motion, les formules d'ouverture de séance) sont retirés du corpus servant au concept distinctif : ils sont très caractéristiques du rôle de qui préside ou lit une motion, pas de son propos politique.
Le nom affiché d'un député provient de l'Assemblée nationale, qui en conserve la graphie officielle, et non du référentiel d'appariement, qui stocke les noms sans accents ni traits d'union. Deux élus homonymes restent deux entrées distinctes, départagées par leur circonscription. Le même référentiel daté détermine le parti auquel chaque intervention est attribuée et fournit les bornes des affiliations affichées sous les cartes.
Chaque intervention n'est comptée qu'une fois, même quand la source la contient en double. Quand la présidence de l'Assemblée dirige les débats, les transcriptions l'identifient par sa fonction (« La Présidente », « Le Vice-Président (M. Benjamin) »); ces interventions sont attribuées à la personne qui préside à ce moment, puis écartées des mesures. Elles ne comptent ni pour cette personne ni pour aucun parti : la présidence de séance est neutre, qu'elle soit tenue par la personne qui préside ou par une vice-présidence. Ce que la même personne dit lorsqu'elle ne préside pas est compté comme pour tout autre élu.
Le module ne couvre que les cinq partis reconnus. Les interventions prononcées sans affiliation à un parti en sont absentes : elles sont écartées avant l'agrégation, et aucun casier ne leur est consacré. Neuf sièges étaient dans cette situation au 5 août 2026. Les totaux affichés par parti ne décrivent donc pas l'ensemble de la chambre.
Les nouvelles séances sont traitées chaque mardi. Lorsque l'Assemblée ne siège pas (relâche estivale ou parlementaire), les chiffres affichés restent ceux de la dernière séance connue.
Répartition par enjeu
Une phrase peut porter plusieurs enjeux à la fois : un propos sur le financement des hôpitaux compte à la fois en santé et en économie. La répartition affichée rapporte donc le nombre d'attributions d'un enjeu au total des attributions de la période, de sorte que les douze parts forment un ensemble de 100 %. Elle se lit comme la part de l'attention thématique, pas comme la part des phrases prononcées.
Cette répartition porte sur les phrases auxquelles au moins un enjeu a été attribué. Une part appréciable du discours parlementaire n'en reçoit aucun : environ 56 % des phrases au 30 juillet 2026, l'essentiel étant des interventions courtes, procédurales ou trop peu explicites pour être classées. La répartition décrit donc ce dont il a été question quand un sujet identifiable était abordé, et non l'intégralité de ce qui a été dit en chambre.
Concept distinctif
Le concept distinctif est l'expression, d'un ou deux mots, qui distingue le plus un député de l'ensemble de l'Assemblée sur la période. Le calcul établit d'abord une liste de candidats en combinant trois signaux : la fréquence de l'expression chez cette personne, le fait qu'elle soit concentrée chez elle plutôt que répandue chez les autres élus, et sa rareté dans l'ensemble du corpus. Ce dernier signal est ce qui distingue un mot d'usage courant en chambre d'un terme employé de façon insistante par une seule voix.
Les candidats sont extraits phrase par phrase, ce qui évite d'assembler des expressions à cheval sur deux phrases. Sont exclus les mots outils français et anglais, le vocabulaire de procédure parlementaire, ainsi que les noms des élus et les noms et sigles de partis : un député n'est pas caractérisé par son propre nom, ni un parti d'opposition par le sigle de celui qu'il critique. Quand une expression de deux mots porte une part substantielle des emplois du mot seul, c'est elle qui est retenue.
Un modèle de langage tranche ensuite entre les soixante meilleurs candidats. Il ne rédige rien : il reçoit la liste calculée et en désigne une seule entrée, celle qui décrit un enjeu de politique publique plutôt que le fonctionnement de la chambre. Sa réponse est vérifiée contre la liste, si bien qu'aucune expression absente du corpus ne peut être publiée. Cette étape existe parce que la statistique seule ne fait pas la différence entre le vocabulaire des travaux parlementaires et celui des politiques débattues : la fréquence, la rareté et la répartition entre élus classent « salle » ou « affaires courantes » aussi haut que « logement abordable ». Quand aucun candidat ne décrit un enjeu substantiel, aucun concept n'est affiché pour cette entité.
Deux élus peuvent avoir la même expression. Chaque député est comparé à l'ensemble de l'Assemblée, séparément des autres : son expression dit ce qui le distingue de la chambre dans son ensemble, et non de chacun de ses collègues. Deux élus qui reviennent sans cesse au même dossier peuvent donc recevoir la même. Au 12 juin 2026, sur la législature, six paires d'élus sont dans ce cas, par exemple « immigration » pour Paul St-Pierre Plamondon et Alex Boissonneault, tous deux du Parti québécois, ou « crise logement » pour Virginie Dufour (PLQ) et Andrés Fontecilla (QS). C'est un choix assumé : réserver chaque expression à un seul élu obligerait à donner aux autres une expression moins représentative de ce qu'ils ont dit, pour la seule raison qu'un collègue en parlait aussi. L'extrait cité sous l'expression, lui, est toujours tiré des interventions de l'élu.
L'extrait placé sous le concept n'est publié que s'il contient tous les mots de l'expression retenue, dans le même ordre. Les mots peuvent être séparés par un déterminant, comme dans « lanceurs d'alerte ». Lorsque le contexte disponible a été coupé avant le concept, le module signale que l'extrait n'est pas disponible plutôt que d'afficher une citation hors sujet.
Diversité lexicale
La diversité lexicale indique si une personne revient souvent aux mêmes mots ou en change fréquemment : c'est la part de mots différents dans ce qu'elle dit. Pour chaque député et chaque jour de séance, une fenêtre de 50 mots glisse sur l'ensemble de ses interventions, remises dans l'ordre; dans chaque fenêtre, on compte la proportion de mots distincts, et la valeur du jour est la moyenne de toutes les fenêtres (indice MATTR, moving-average type-token ratio). Un jour où la personne a prononcé moins de 50 mots ne remplit aucune fenêtre : sa valeur est alors le simple rapport entre mots distincts et mots prononcés. La fenêtre fixe évite qu'une personne qui parle beaucoup paraisse mécaniquement moins variée : sur un texte entier, le rapport entre mots différents et mots prononcés baisse toujours avec la longueur. La valeur d'une période est la moyenne des valeurs journalières. Les mots sont comptés tels qu'ils apparaissent, en minuscules, sans regroupement des formes (« loi » et « lois » sont deux mots) et sans retrait des mots courants (« de », « la », « que »), ce qui place les élus dans une bande étroite : de 0,77 à 0,85 sur la législature, plus large sur une période courte, où chaque élu ne compte que quelques jours de séance (0,73 à 0,90 sur la session, 0,72 à 0,89 sur la dernière journée de débats, au 12 juin 2026). La mesure d'un parti suit la même méthode sur l'ensemble de ses interventions.
Sur les cartes, la diversité est exprimée de un à cinq points, sur une échelle relative à toute l'Assemblée : pour une période donnée, l'ensemble des élus des cinq partis du module ayant pris la parole est partagé en cinq groupes d'effectif égal selon leur valeur, et chaque personne reçoit le rang de son groupe. Les interventions prononcées sans affiliation, écartées du module, n'entrent pas dans ce classement. Une personne qui a changé de parti est classée une seule fois, sur sa valeur toutes allégeances confondues (moyenne de ses valeurs pondérée par les mots) : ses cartes dans les deux casiers portent le même nombre de points. Cinq points désignent le cinquième de l'Assemblée au vocabulaire le plus varié, un point le cinquième le moins varié. Les points se lisent donc par comparaison avec tous les élus de la période, pas à l'intérieur d'un parti, et deux personnes de partis différents ayant le même nombre de points sont bien comparables. Auparavant, l'échelle était recalculée dans chaque parti, entre sa valeur la plus faible et la plus forte, si bien que les points ne se comparaient pas d'un casier à l'autre; les cartes imprimées en septembre 2026 portent cette ancienne échelle, sous le libellé « richesse lexicale ». Pour les partis, les points étirent les valeurs des partis actifs de la période entre la plus faible (un point) et la plus forte (cinq points).
La diversité lexicale ne mesure ni la qualité de la langue, ni la grammaire, ni le niveau de vocabulaire, ni la complexité du propos : répéter un mot-clé pour marteler un message fait baisser le score, employer un mot rare ne le fait pas monter. Elle reflète d'abord le registre : la période de questions, où l'on reprend volontairement les mêmes formules et où l'on interpelle sans cesse un ministre, tire le score vers le bas; l'étude détaillée d'un projet de loi en commission, au vocabulaire plus technique et plus changeant, le tire vers le haut.
Ton en chambre
Chaque phrase reçoit un ton favorable, défavorable ou neutre, pondéré par la confiance du classement. Le ton d'un parti est la moyenne de ces valeurs, calculée sur les seules phrases porteuses d'un enjeu. Les formules d'ouverture, les remerciements et les civilités de séance en sont écartés : le classificateur les juge favorables, et comme elles représentent une large part des interventions, elles tiraient la mesure vers le haut au point d'afficher des partis d'opposition au ton favorable.
Le ton mesuré reste resserré autour de zéro, si bien qu'une valeur brute ne dirait pas grand-chose. L'échelle affichée place donc un repère sur une règle calée sur l'étendue réellement observée pendant la période : la voix la plus défavorable en occupe la gauche, la plus favorable la droite, et le point neutre reste au centre. Une position se lit par comparaison avec les autres élus de la même période, jamais comme une note absolue. Le sens du ton est la partie fiable de cette mesure; son intensité l'est beaucoup moins.
Fenêtres temporelles
La législature complète est la vue affichée par défaut. L'onglet « dernière journée de débats » couvre le jour le plus récent pour lequel une transcription est disponible, « cette session » la session parlementaire en cours. L'onglet « cette législature » remonte à la première séance présente dans nos données, qui n'est pas nécessairement la première séance de la législature : la profondeur de l'historique dépend de la date de mise en service de la collecte.
Affichage
Le module se présente comme un vestiaire : un casier par parti, au format des cartes, alignés côte à côte. Les cinq partis gardent leur casier dans toutes les vues, rangés du plus bavard au moins bavard selon le volume de mots prononcés sur la période. La porte ne porte que le nom du parti et son écusson; un casier est toujours ouvert, le premier d'entrée de jeu, pour que le module garde la même taille. Cliquer un autre casier ouvre sa porte, qui révèle le bilan du parti : mots prononcés, interventions, député·es ayant pris la parole, position sur l'échelle de ton, trois principaux sujets abordés et l'élu qui a le plus parlé. Un casier sans parole dans la vue reste sur le banc, vide, avec ses chiffres à zéro et la raison : aucun élu du parti ne siégeait pendant la période, ou aucun n'a pris la parole. Sous la rangée se déroule un tiroir relié au casier ouvert, qui porte le présentoir des cartes de ses député·es, montrées côté recto; un sélecteur les retourne toutes côté verso, celui des données, et un clic en retourne une. Sur tablette, où les casiers sont plus étroits, la porte ouverte ne montre que deux sujets et omet l'élu qui a le plus parlé : le présentoir, juste dessous, commence par lui. Sur téléphone, les cartes passent au premier plan : le banc de casiers cède la place à un filtre par parti, et le présentoir occupe la largeur de l'écran.
Chaque député ayant pris la parole a sa carte, et c'est la carte de collection imprimée elle-même (63,5 × 88,9 mm), rendue par le même code : ce qu'on voit à l'écran est ce qu'on tient en main. Le recto porte le portrait, le nom, la circonscription, l'écusson du parti auquel les interventions sont attribuées, un numéro de carte, des fleurs de lys qui disent la rareté, le pictogramme de l'enjeu dominant et le sigle de la fonction. La retourner d'un clic révèle le verso : fiche électorale, fiche à l'Assemblée (interventions, mots prononcés, diversité lexicale, ton), parcours et rémunération, part des interventions par enjeu, expression distinctive et sa citation. Le verso ne porte que des données : les sources et la méthode sont sur cette page. Les cartes sont détaillées ci-dessous. Dans la vue de la législature, un avis repliable apparaît sous la carte lorsqu'un parcours demande une précision. Il date les changements d'affiliation, l'entrée à l'Assemblée lors d'une élection partielle et la fin d'un mandat par démission. Une même personne peut donc apparaître dans plusieurs casiers, puisque ses interventions restent associées à l'affiliation détenue au moment où elles ont été prononcées.
Les portraits proviennent du site de l'Assemblée nationale du Québec, qui en autorise la reproduction pour un usage non commercial à condition d'en indiquer la source. Ils sont retraités en bichromie pour s'accorder à la mise en page. Ce retraitement est calculé image par image, de façon à ce que le rendu d'un visage ne dépende pas de sa carnation.
Trois onglets permettent de basculer entre la législature, la dernière journée de débats et la session en cours.
Les cartes de député
La carte est la même sur le site et sur le carton imprimé : un seul gabarit, dessiné pour l'impression (63,5 × 88,9 mm) et réduit à l'écran. Sa grammaire est celle des cartes de collection des années 1980 : carton clair, portrait cerné d'un filet, écusson en haut à droite, bandeau de couleur au bas avec le nom. Rien n'y est inventé : chaque élément est une donnée, et la note au bas du verso les nomme.
Numéro. Un numéro par siège, dans l'ordre alphabétique des circonscriptions : 125 sièges pour la législature. Un député remplacé en cours de route (démission, décès) partage le numéro de son siège, suivi d'une lettre; l'élu en poste garde le numéro nu. La série imprimée compte ainsi 129 cartes. Les vues « cette session » et « dernière journée de débats » sont des éditions en ligne, numérotées de la même façon parmi les élus qui y ont pris la parole : une même personne n'y porte donc pas forcément le numéro de sa carte de législature.
Rareté. Dite par les fleurs de lys sous la circonscription (une à quatre) et par le métal du filet. Les premiers ministres de la législature sont légendaires, hors calcul. Tous les autres élus, chefs compris, sont classés sur les mots qu'ils ont prononcés au Salon bleu pendant la période de la vue affichée (la législature, pour le carton imprimé) : les 10 % les plus bavards sont rares, les 35 % suivants peu communs, le reste communs. Les mots plutôt que les interventions, parce que les vice-présidents cumulent des milliers d'interventions de procédure de quelques mots. La personne qui préside l'Assemblée est commune d'office : ce qu'elle dit en présidant n'est pas attribué à son nom dans les transcriptions.
Fonction. Le sigle du recto (PM, M, CO, LP, W, PC, AP, D…) désigne la fonction la mieux rémunérée exercée pendant la législature, explicitée au pied de la carte; sa durée n'entre pas en compte, dix-sept jours de ministère donnent « M ». Les fonctions viennent de la fiche de chaque député sur le site de l'Assemblée nationale, qui les date une à une. Seul le titre de première ministre est saisi à la main; les rubans de chef parlementaire sont tirés de ces fiches, pour la fonction encore occupée à la dissolution.
Fiche électorale. Part des voix et avance sur le deuxième au scrutin qui a donné le siège (générale du 3 octobre 2022 ou partielle), d'après les données ouvertes d'Élections Québec; le nombre de mandats et l'année de la première élection viennent du référentiel des parlementaires. Un changement d'allégeance ou un départ en cours de législature est écrit sous les chiffres, avec sa date.
Parcours et rémunération. La frise va de l'élection générale à la dissolution, la même sur toutes les cartes; chaque fonction y est un aplat d'autant plus plein qu'elle est payée, l'indemnité de base seule laisse la piste nue, et le temps hors mandat est hachuré. Le montant est l'indemnité annuelle de base plus l'indemnité additionnelle de la fonction la mieux payée, calculées jour par jour du début du mandat à la dissolution ou au départ, puis ramenées à une année : les indemnités ne se cumulent pas, et un élu de partielle ne paraît pas sous-payé. Ni allocations de dépenses ou de transition, ni régime de retraite, ni remboursements de frais. Barème : les pages « Indemnités et allocations » de l'Assemblée, dans leurs versions successives.
Part des interventions, expression distinctive, diversité lexicale et ton sont les mesures décrites plus haut, reprises telles quelles. La fiche à l'Assemblée porte les chiffres de la période affichée, mais pour la personne entière et non pour un seul casier : les interventions et les mots de toutes ses allégeances de la période y sont additionnés, y compris la parole prononcée sans affiliation, que les casiers écartent. Le ton et la part des interventions par enjeu en sont la moyenne pondérée par les mots; l'expression distinctive est celle de l'allégeance où la personne a le plus parlé. Le verso d'une personne qui a changé d'allégeance compte donc plus de mots que son casier. Le portrait est celui de l'Assemblée nationale, tramé en quadrichromie d'époque; la trame est calculée image par image, de sorte que le rendu d'un visage ne dépende pas de sa carnation.
Limites. Les appariements entre les transcriptions, les fiches de l'Assemblée, le référentiel des parlementaires et les résultats électoraux se font par nom et par circonscription; ils sont vérifiés à la main, et une expression distinctive jugée trompeuse peut être retirée d'une carte, la décision étant consignée. Les cartes imprimées en septembre 2026 portent l'ancien libellé « richesse lexicale » et son ancienne échelle, calculée par parti.
§ 09
Fenêtres temporelles
Les modules de couverture médiatique sont disponibles selon trois fenêtres temporelles distinctes : le jour, la semaine et la campagne.
| Fenêtre | Portée | Fréquence de mise à jour |
|---|---|---|
| Jour | Blocs de 4h du jour courant | 6 fois par jour (00h, 04h, 08h, 12h, 16h, 20h, heure de Montréal) |
| Semaine | Les sept derniers jours : le jour de l'édition et les six qui le précèdent, heure de Montréal | 6 fois par jour, avec chaque édition |
| Campagne | Depuis le déclenchement du scrutin, le 27 août 2026 | 6 fois par jour, avec chaque édition |
Le système applique une pondération décroissante à l'intérieur de chaque fenêtre : les événements récents contribuent davantage au score final que les événements anciens.
§ 10
Limites reconnues
Aucune mesure n'est neutre. La Vitrine revendique sa rigueur en exposant aussi ses limites.
1 · Sélection des sources médiatiques
Le corpus couvre 13 sources d'information générale établies. Les médias alternatifs, hyperlocalaux, spécialisés et les plateformes de médias sociaux ne sont pas inclus. Ce choix sur-représente les acteurs médiatiques nationaux et les formats de presse traditionnelle.
2 · Pages frontales ≠ couverture totale
Les pages d'accueil ne constituent qu'une fraction de la production journalistique. Certains sujets font l'objet d'une couverture approfondie sans jamais atteindre la une. L'indice mesure la visibilité frontale, pas l'ensemble de la couverture.
3 · Imperfections des modèles d'IA
Le modèle d'extraction peut produire des erreurs sur les homonymes, les entités émergentes et les personnalités peu connues. Des validations humaines régulières réduisent ces erreurs, sans les éliminer.
4 · Limites des dictionnaires de sentiment
L'approche par dictionnaire ne capte pas l'ironie, le sarcasme ou les nuances contextuelles. La valence d'un mot peut varier fortement selon la phrase qui l'entoure.
5 · Comparabilité inter-langues
Les indices calculés séparément pour les médias francophones et anglophones ne sont pas directement comparables en valeur absolue, en raison des différences stylistiques entre les deux groupes.
6 · Instantanés statiques
Les données publiées sont des instantanés (snapshots) mis à jour automatiquement six fois par jour par un pipeline AWS. Les scores affichés correspondent au dernier cycle de collecte et d'analyse, non à un flux continu en temps réel.
7 · L'Assemblée n'est pas couverte en entier
Le module « L'alignement de l'Assemblée » ne traite que les cinq partis reconnus. Les député.es qui siègent sans affiliation à un parti en sont absent.es, alors que neuf sièges étaient dans cette situation au 5 août 2026, dont d'ancien.nes ministres. Une personne qui change d'affiliation garde, dans les totaux, la parole prononcée sous sa bannière précédente. L'avis repliable sous sa carte permet de dater ce changement et, selon le cas, une élection partielle ou une démission. Les interventions prononcées sans affiliation à un parti ne sont toujours pas représentées dans un casier.
8 · Regroupement non reproductible à l'identique
Le regroupement des articles en histoires est confié à un modèle de langue. Deux exécutions sur les mêmes articles s'accordent à environ 97 %, sans être identiques : recalculer une journée passée ne redonnerait donc pas exactement les mêmes histoires. Le découpage publié est une décision datée, figée au moment de la publication. Les indices de saillance des objets, eux, restent calculés de façon déterministe et sont reproductibles (§ 03).
9 · Pages permanentes exclues du corpus
Certaines pages ne sont jamais des nouvelles mais occupent parfois la une : flux vidéo continu, page de chaîne. Une page qui ne change jamais accumule du temps‑en‑une sans rien raconter, ce qui gonfle artificiellement la durée mesurée. Ces pages sont donc exclues du calcul, à partir d'une liste d'adresses tenue à la main et révisée par un humain. Le critère est la durée de vie et non le libellé : les pages « en direct » consacrées à un événement réel, qui portent un titre propre et disparaissent en quelques jours, sont conservées. Au 8 août 2026, la liste compte deux adresses.
Une vidéo placée à la Une pose un problème voisin : la page n'a pas de texte à analyser. Chez CNN, quand la Une est une vidéo de reportage, la collecte retient le premier article du même bloc, qui traite du même sujet; quand c'est un épisode de l'offre vidéo payante de CNN, la capture est exclue, comme une page permanente.
10 · Les partis québécois sont désormais reconnus, sauf un
Le modèle a été réentraîné en août 2026 : neuf modèles binaires remplacent le classifieur unique, chacun ne jugeant que d'un seul parti. La justesse mesurée sur un jeu annoté par quatre personnes passe de 0,61 à 0,94. La mesure a donc repris.
Deux limites subsistent. Le Parti conservateur du Québec n'est plus reconnu : ses 18 exemples d'entraînement désignaient en majorité des conservateurs d'une autre province, et nous avons préféré ne pas le détecter du tout plutôt que de le détecter à tort. Sa colonne reste à zéro : ce zéro dit notre incapacité à le mesurer, non son absence des médias. Quatre autres partis reposent sur moins de dix exemples positifs, et deux d'entre eux sur un seul : leurs chiffres sont des ordres de grandeur, pas des mesures fines.
Les valeurs publiées avant la bascule viennent de l'ancien modèle et ne sont pas comparables aux suivantes.
L'historique n'a pas été recalculé. La mesure ne porte donc que sur les articles annotés depuis le 21 août 2026, et les périodes « semaine » et « campagne » sont tronquées d'autant : elles affichent pour l'instant à peu près la même fenêtre que la journée. Elles s'étofferont jour après jour. Nous avons préféré une fenêtre courte et juste à une fenêtre longue mêlant deux modèles, dont les valeurs ne se comparent pas.
§ 11
Éthique et transparence
- Le CAPP détient les autorisations éthiques requises pour la collecte et le traitement des données, conformément aux politiques de l'Université Laval.
- Les données sont hébergées au Québec, dans les infrastructures cloud du CAPP. Aucune donnée personnelle n'est transmise à des tiers.
- Aucune donnée permettant d'identifier un individu n'est utilisée dans le calcul des indices de saillance médiatique ou parlementaire.
- Les modèles d'intelligence artificielle sont les nôtres. Les 30 classifieurs qui lisent les phrases des articles (21 thèmes, 9 partis) et le modèle de sentiment sont des modèles locaux, entraînés, calibrés et validés par notre équipe. Leur rapport de validation complet est public : voir ci-dessous.
- Le code de traitement des données est disponible sur les dépôts GitHub publics du CAPP et d'Ellipse Sciences (github.com/ellipse-science).
Rapport de validation des modèles · 30 août 2026
Distillation. Les 30 modèles servis à la Vitrine sont des encodeurs légers (mDeBERTa), un par thème et un par parti, entraînés sur un corpus de 99 997 phrases bilingues tirées de la presse et des débats parlementaires. Ce corpus a été annoté par un grand modèle de langue (gpt-5.4), puis les modèles légers ont été distillés à partir de ces annotations. Chaque modèle répond à une seule question (« ce thème est-il présent dans cette phrase? »), ce qui permet de le mesurer, de le remplacer ou de le retirer sans toucher aux autres.
Calibration. Le seuil de décision de chaque tête thématique a été réglé sur des phrases annotées à la main, par validation croisée répétée deux cents fois, pour que le modèle ne dise « oui » ni trop souvent ni trop rarement. Les têtes de partis sont servies au seuil de 0,5, sans calibration.
Validation. Les modèles ont été confrontés à 2 273 phrases annotées par des humains, hors du corpus d'entraînement. Le F1 moyen de la classe positive est de 0,656 pour les thèmes (13 têtes sur 21 dépassent 0,65; domestic_commerce et public_lands sont les moins sûrs), de 0,934 à 0,994 pour les quatre partis fédéraux disposant d'assez de cas de référence, et de 0,653 pour le sentiment, contre un accord entre annotateurs humains de 0,669. Les cinq partis provinciaux ne sont pas encore validés faute de cas de référence, et le Parti conservateur du Québec n'a pas de modèle. Aucun chiffre du rapport n'est saisi à la main : les tableaux sont régénérés depuis les journaux d'entraînement versionnés.
Une page dédiée résume nos valeurs, notre usage scientifique de l'IA et ses limites : Nos modèles d'intelligence artificielle. Le parcours de la donnée, de la collecte à la publication, est décrit sur la page Notre infrastructure de données.
Lire le rapport de validation complet (PDF) ↓
Réalisé avec
§ 12
Citation et accès aux données
Si vous utilisez les données ou les indices de la Vitrine Démocratique dans vos travaux, veuillez citer :
Pour toute demande d'accès aux données brutes ou pour établir une collaboration de recherche, utilisez le formulaire d'accès aux données ou écrivez à info@capp.ulaval.ca.
§ 13 · Module expérimental
Module : La guerre des clics
Ce module est expérimental : sa présentation peut encore évoluer. Il décrit l'activité des candidates et des candidats aux élections générales québécoises de 2026 sur Facebook, Instagram et TikTok, ainsi que celle des comptes officiels des cinq partis.
Source des données
Le point de départ est la liste des candidatures officielles des cinq partis publiée par Élections Québec, close le 25 septembre 2026 : 635 candidatures, soit 127 par parti. Les comptes de chaque personne ont été cherchés sur les trois plateformes, puis vérifiés un à un par l'équipe avant d'entrer dans la collecte. S'y ajoutent les comptes officiels des partis, un par parti et par plateforme.
La collecte passe plusieurs fois par jour sur chaque compte. Elle relève le nombre d'abonnés et les publications, avec leur texte, leur date et leurs nombres de j'aime et de commentaires. L'historique remonte au 1er avril 2026. Au 30 septembre 2026, 1 003 comptes étaient suivis et 602 des 635 candidatures avaient au moins un compte collecté.
Ce qui est mesuré
Le module propose quatre indicateurs. Le nombre d'abonnés est celui du dernier relevé de chaque compte : il ne dépend pas de la période choisie. Les publications, les j'aime et les commentaires sont comptés par jour de publication, puis additionnés sur la période.
La collecte relit une publication à chaque passage, et ses compteurs continuent de grimper pendant des jours. Seule la dernière observation est retenue : chaque publication compte une fois, avec ses chiffres les plus récents. Une publication signée par deux comptes compte pour chacun d'eux. La date retenue est le jour de mise en ligne en temps universel; Facebook ne fournit que le jour, sans l'heure.
Affichage
Le module s'ouvre sur la campagne, depuis le déclenchement des élections le 27 août 2026; la période se règle ensuite à volonté. Les filtres par plateforme et par parti s'appliquent à toutes les vues.
La vue Par parti additionne l'indicateur choisi pour chaque parti. Chaque barre se découpe par plateforme, et un second graphique en suit l'évolution par jour, ou par semaine quand la période dépasse 45 jours. La vue Par candidat classe les 20 comptes de candidates et de candidats en tête pour l'indicateur choisi; les comptes officiels des partis n'y figurent pas. Un clic sur un compte affiche ses dernières publications, avec un lien vers chacune sur sa plateforme.
La vue Par publication montre les 10 publications les plus aimées ou les plus commentées de la période. Elles sont choisies parmi les publications les plus aimées de chaque jour des 60 derniers jours : une publication très commentée mais peu aimée peut donc y manquer. Sur la carte de la vue Par circonscription, chaque circonscription prend la couleur du parti dont les candidates et les candidats arrivent en tête pour l'indicateur et la période choisis; plus la couleur est soutenue, plus le total est élevé.
Limites
- Seuls les comptes publics sont collectés. Les comptes privés et les profils personnels Facebook, que la collecte ne peut pas lire, en sont absents : une personne qui ne publie que sur son profil personnel n'apparaît pas.
- Au 30 septembre 2026, 33 candidatures n'avaient aucun compte collecté : soit la personne n'a pas de compte public, soit son compte n'a pas été retrouvé.
- Les chiffres sont ceux qu'affichent les plateformes. TikTok arrondit ses nombres d'abonnés et de j'aime au-delà de 10 000 (par exemple 61 300).
- Les j'aime et les commentaires mesurent une réaction en ligne, pas un appui électoral. Ils dépendent aussi de la taille de l'auditoire de chaque compte.